# 数据库基础篇
# 1.SQL
# 1.1 SQL通用语法
在学习具体的SQL语句之前,先来了解一下SQL语言的同于语法。
1). SQL语句可以单行或多行书写,以分号结尾。
2). SQL语句可以使用空格/缩进来增强语句的可读性。
3). MySQL数据库的SQL语句不区分大小写,关键字建议使用大写。
4). 注释:
单行注释:-- 注释内容 或 # 注释内容
多行注释:/* 注释内容 */
# 1.2 SQL分类
SQL语句,根据其功能,主要分为四类:DDL、DML、DQL、DCL
| 分类 | 全称 | 说明 |
|---|---|---|
| DDL | Data Definition Language | 数据定义语言,用来定义数据库对象(数据库,表,字段) |
| DML | Data Manipulation Language | 数据操作语言,用来对数据库表中的数据进行增删改 |
| DQL | Data Query Language | 数据查询语言,用来查询数据库中表的记录 |
| DCL | Data Control Language | 数据控制语言,用来创建数据库用户、控制数据库的访问权限 |
# 1.3表操作的数据类型
MySQL中的数据类型有很多,主要分为三类:数值类型、字符串类型、日期时间类型。
# 一、数值类型
| 类型 | 大小 | 范围(有符号) | 范围(无符号) | 用途 |
|---|---|---|---|---|
TINYINT | 1 字节 | -128 ~ 127 | 0 ~ 255 | 小整数,如状态标记、年龄 |
SMALLINT | 2 字节 | -32768 ~ 32767 | 0 ~ 65535 | 较小整数,如数量、编码 |
MEDIUMINT | 3 字节 | -8388608 ~ 8388607 | 0 ~ 16777215 | 中等大小整数 |
INT/INTEGER | 4 字节 | -2147483648 ~ 2147483647 | 0 ~ 4294967295 | 常用整数,如 ID、订单号 |
BIGINT | 8 字节 | -9223372036854775808 ~ 9223372036854775807 | 0 ~ 18446744073709551615 | 大整数,如金额、时间戳 |
FLOAT | 4 字节 | 单精度浮点数,精度约 6~7 位 | — | 科学计算、近似值存储 |
DOUBLE | 8 字节 | 双精度浮点数,精度约 15~16 位 | — | 更高精度的浮点数存储 |
DECIMAL(M,D) | 可变 | 精确小数,M为总位数,D为小数位数 | — | 金融、货币等精确计算场景 |
# 二、字符串类型
| 类型 | 大小 | 说明与用途 |
|---|---|---|
CHAR(M) | 固定 M 字节 | 长度固定,M最大为 255。适合存储长度固定的字符串,如邮编、手机号 |
VARCHAR(M) | 可变,最大 M 字节 | 长度可变,M最大为 65535。适合存储长度可变的字符串,如姓名、地址 |
TINYBLOB | 0-255 字节 | 不超过255个字符的二进制数据 |
BLOB | 0-65535 字节 | 二进制形式的长文本数据 |
MEDIUMBLOB | 0-16777215 字节 | 二进制形式的中等长度文本数据 |
LONGBLOB | 0-4294967295 字节 | 二进制形式的极大文本数据 |
TINYTEXT | 0-255 字节 | 短文本字符串 |
TEXT | 最大 65535 字节 | 长文本,适合存储文章、描述等较长内容 |
MEDIUMTEXT | 最大 16777215 字节 | 中等长度文本,适合存储更长的内容 |
LONGTEXT | 最大 4294967295 字节 | 极大文本,适合存储超大型文本 |
# 三、日期时间类型
| 类型 | 大小 | 范围 | 用途 |
|---|---|---|---|
DATE | 3 字节 | 1000-01-01 ~ 9999-12-31 | 存储日期(年 - 月 - 日) |
TIME | 3 字节 | -838:59:59 ~ 838:59:59 | 存储时间(时:分: 秒) |
DATETIME | 8 字节 | 1000-01-01 00:00:00 ~ 9999-12-31 23:59:59 | 存储日期 + 时间,不受时区影响 |
TIMESTAMP | 4 字节 | 1970-01-01 00:00:01 ~ 2038-01-19 03:14:07 | 存储日期 + 时间,受时区影响,常用于记录创建 / 更新时间 |
YEAR | 1 字节 | 1901 ~ 2155 | 存储年份 |
# 1.4SQL语句
DDL(数据定义语言)
CREATE:创建数据库、表或其他对象ALTER:修改数据库或表的结构DROP:删除数据库、表或其他对象TRUNCATE:清空表中所有数据(保留表结构)
创建数据库
-- 创建数据库
create database [ if not exists ] 数据库名 [ default charset 字符集 ] [ collate 排序
规则 ] ;
-- 示例
create database if not extists db_test;
-- 指定字符集
create database db_t default charset utf8mb4;
2
3
4
5
6
7
删除数据库
-- 删除数据库
drop database [ if exists ] 数据库名 ;
-- 示例
drop database if exists db_t;
2
3
4
创建表结构
-- 创建表
CREATE TABLE 表名 (
字段 1 数据类型 [约束],
字段 2 数据类型 [约束],
.....
);
-- 示例
create table tb_user(
id int comment '编号',
name varchar(50) comment '姓名',
age int comment '年龄',
gender varchar(1) comment '性别'
) comment '用户表';
2
3
4
5
6
7
8
9
10
11
12
13
修改表操作
-- 添加字段
ALTER TABLE 表名 ADD 字段名 数据类型 [约束];
-- 示例
alter table tb_user add phone char(11) comment '手机号';
-- 修改字段类型
ALTER TABLE 表名 MODIFY 字段名 新数据类型;
-- 示例
alter table tb_user modify age tinyint
-- 删除字段
ALTER TABLE 表名 DROP 字段名;
-- 示例
alter table tb_user drop phone;
-- 修改表名
ALTER TABLE 表名 RENAME TO 新表名;
-- 示例
alter table tb_user rename to user;
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
删除表和清空表中数据
-- 删除表
DROP TABLE [IF EXISTS] 表名;

-- 清空表中数据
TRUNCATE TABLE 表名;
2
3
4
5
# DML(数据操作语言)
INSERT:向表中插入新数据UPDATE:更新表中现有数据DELETE:删除表中数据
插入操作
--先创建一个表,方便后续操作
create table employee(
id int comment '编号',
workno varchar(10) comment '工号',
name varchar(10) comment '姓名',
gender char(1) comment '性别',
age tinyint unsigned comment '年龄',
idcard char(18) comment '身份证号',
entrydate date comment '入职时间'
) comment '员工表';

-- 插入指定字段
INSERT INTO 表名 (字段1, 字段2, ...) VALUES (值1, 值2, ...);
--示例
isert into employee(id,workno,name,gender,age,idcard,entrydate)
values(1,'1','yang','男',10,'123456789012345678','2000-01-01');
-- 插入所有字段(字段顺序与表结构一致)
INSERT INTO 表名 VALUES (值1, 值2, ...);
--示例
insert into employee values(2,'2','张无','男',18,'123456789012345670','2005-01-01');
-- 插入多条数据
INSERT INTO 表名 (字段名1, 字段名2, ...) VALUES (值1, 值2, ...), (值1, 值2, ...), (值
1, 值2, ...) ;
-- 示例
insert into employee values(3,'3','韦微','男',38,'123456789012345670','2005-01-01'),
                           (4,'4','赵敏','女',18,'123456789012345670','2005-01-01');
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
注意事项:
1.插入数据时,指定的字段顺序需要与值的顺序是一一对应的。
字符串和日期型数据应该包含在引号中。
插入的数据大小,应该在字段的规定范围内。
更新操作
-- 更新表中数据
UPDATE 表名
SET 字段1=值1, 字段2=值2
WHERE 条件; -- 必加WHERE,否则更新全表!
-- 示例
update employee set name = '小龙女' where id = 1;
2
3
4
5
6
删除操作
-- 删除表中数据
DELETE FROM 表名 WHERE 条件; -- 必加WHERE,否则删除全表
-- 示例
delete from employee where gender = '女';
2
3
4
# DQL(数据查询语言)
SELECT:查询表中的数据(最核心的命令,可搭配WHERE、GROUP BY等使用)
查询的基本结构如下,下面我们将从这几方面入手学习查询语句:
1.基本查询
2.条件查询
3.聚合函数
4.分组查询
5.排序查询
6.分页查询
SELECT 字段列表 FROM 表名列表 WHERE 条件列表 GROUP BY 分组字段列表
HAVING 分组后条件列表 ORDER BY 排序字段列表 LIMIT 分页参数
2
准备工作
-- 创建用户表
CREATE TABLE users (
  id INT PRIMARY KEY AUTO_INCREMENT,
  name VARCHAR(50) NOT NULL,
  age INT,
  salary DECIMAL(10,2),
  dept VARCHAR(30) -- 部门
);

-- 插入测试数据
INSERT INTO users (name, age, salary, dept) VALUES
('张三', 25, 8000.00, '研发部'),
('李四', 30, 12000.00, '研发部'),
('王五', 28, 9000.00, '市场部'),
('赵六', 35, 15000.00, '市场部'),
('孙七', 22, 6000.00, '人事部'),
('周八', 40, 20000.00, '研发部');
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 1.基本查询
-- 查询所有字段
SELECT * FROM 表名;

-- 查询指定字段
SELECT 字段1, 字段2 FROM 表名;

-- 示例1:查询所有用户的所有信息
SELECT * FROM users;
-- 输出:会显示users表中6条数据的所有字段(id、name、age、salary、dept)

-- 示例2:只查询用户姓名和部门(指定字段)
SELECT name, dept FROM users;
-- 输出:仅显示6条数据的name和dept列,如:张三 研发部、李四 研发部...
2
3
4
5
6
7
8
9
10
11
12
13
# 2.条件查询
在学习条件查询之前,我们先要知道可以构造条件的关键字,如下:
比较运算符
| 运算符 | 功能描述 |
|---|---|
| > | 大于 |
| >= | 大于等于 |
| < | 小于 |
| <= | 小于等于 |
| = | 等于 |
| <> 或 != | 不等于 |
| BETWEEN … AND … | 在某个范围之内(包含边界) |
| IN(…) | 在列表中的值,多选一 |
| LIKE | 模糊匹配 |
| IS NULL | 是 NULL 值 |
逻辑运算符
| 运算符 | 功能描述 |
|---|---|
| AND 或 && | 并且(多个条件同时成立) |
| OR 或 | | 或者(多个条件任意一个成立) |
| NOT 或 ! | 非,不是 |
基础语法结构
下面是应用实例,我举几个典型的示例,另外几种大家可以自己尝试一下
SELECT 字段列表 FROM 表名 WHERE 条件表达式;
1.比较运算符 - 年龄大于30岁的用户
SELECT * FROM users WHERE age > 30;
-- 输出:赵六(35岁)、周八(40岁)
2
2.BETWEEN运算符 - 查询薪资范围
SELECT name, salary, dept FROM users
WHERE salary BETWEEN 8000 AND 15000;
-- 输出:张三(8000)、李四(12000)、王五(9000)、赵六(15000)
2
3
3.IN运算符 - 查询多个部门的员工
SELECT name, dept FROM users
WHERE dept IN ('研发部', '市场部');
-- 输出:张三、李四、王五、赵六、周八(不含人事部的孙七)
2
3
4.LIKE运算符 - 模糊查询
-- 查询姓"张"的员工(使用%匹配任意字符)
SELECT * FROM users WHERE name LIKE '张%';
-- 输出:张三

-- 查询姓名第二个字是"三"的员工(使用_匹配单个字符)
SELECT * FROM users WHERE name LIKE '_三';
-- 输出:无匹配(因为需要两个字符,第二个字是三)
2
3
4
5
6
7
5.逻辑运算符AND - 多个条件同时满足
-- 查询年龄大于25岁且薪资大于10000的员工
SELECT name, age, salary FROM users
WHERE age > 25 AND salary > 10000;
-- 输出:李四(30岁,12000)、赵六(35岁,15000)、周八(40岁,20000)
2
3
4
6.NULL值判断
-- 先添加一条没有年龄信息的员工
INSERT INTO users (name, salary, dept) VALUES ('吴九', 7000.00, '人事部');

-- 查询年龄为NULL的员工
SELECT name, age FROM users WHERE age IS NULL;
-- 输出:吴九(NULL)

-- 查询年龄不为NULL的员工
SELECT name, age FROM users WHERE age IS NOT NULL;
-- 输出:其他所有有年龄记录的用户
2
3
4
5
6
7
8
9
10
# 3.聚合函数
| 函数 | 功能描述 | 语法示例 | 返回值说明 |
|---|---|---|---|
| COUNT | 统计行数(数量) | SELECT COUNT(*) FROM users; | 返回表中总行数 |
SELECT COUNT(dept) FROM users; | 返回指定列非NULL值的行数 | ||
| MAX | 获取最大值 | SELECT MAX(salary) FROM users; | 返回salary列的最大值 |
| MIN | 获取最小值 | SELECT MIN(age) FROM users; | 返回age列的最小值 |
| AVG | 计算平均值 | SELECT AVG(salary) FROM users; | 返回salary列的平均值 |
| SUM | 计算总和 | SELECT SUM(salary) FROM users; | 返回salary列的总和 |
下面我们通过案例具体感受一下
-- 示例1:统计总用户数
SELECT COUNT(*) AS total_users FROM users;
-- 输出:total_users = 7

-- 示例2:统计有年龄的用户数
SELECT COUNT(age) AS total_users FROM users;
-- 输出:total_users = 6

-- 示例3:求研发部薪资的最大值、最小值、平均值
SELECT
  MAX(salary) AS max_salary,
  MIN(salary) AS min_salary,
  AVG(salary) AS avg_salary
FROM users WHERE dept = '研发部';
-- 输出:max_salary=20000,min_salary=8000,avg_salary=13333.33

-- 示例4:求所有用户的薪资总和
SELECT SUM(salary) AS total_salary FROM users;
-- 输出:total_salary = 77000. 算上年龄为空的吴九
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
注意:
- 聚合函数会忽略 NULL 值(比如某行 salary 为 NULL,不会参与 avg/sum 计算);
- 用 AS 给聚合结果起别名,方便阅读。
# 4.分组查询
核心语法和示例
SELECT 分组字段, 聚合函数(字段) FROM 表名
[WHERE 条件]
GROUP BY 分组字段;
-- 逻辑:先按WHERE筛选数据,再按分组字段分组,最后计算聚合函数

-- 示例:按部门分组,统计每个部门的人数、平均薪资
SELECT
  dept AS 部门,
  COUNT(*) AS 人数,
  AVG(salary) AS 平均薪资
FROM users
GROUP BY dept;
-- 输出:
-- 研发部 | 3 | 13333.33
-- 市场部 | 2 | 12000.00
-- 人事部 | 2 | 6500.00
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 5.排序查询
核心语法和示例
SELECT 字段 FROM 表名
[WHERE 条件]
ORDER BY 排序字段1 [ASC/DESC], 排序字段2 [ASC/DESC];
-- ASC:升序(默认,可省略),DESC:降序


-- 示例1:按年龄升序排列所有用户
SELECT name, age FROM users ORDER BY age;
-- 输出:吴九(null)->孙七(22)→ 张三(25)→ 王五(28)→ 李四(30)→ 赵六(35)→ 周八(40)

-- 示例2:按部门分组后,按平均薪资降序排列
SELECT
  dept AS 部门,
  AVG(salary) AS 平均薪资
FROM users
GROUP BY dept
ORDER BY 平均薪资 DESC;
-- 输出:研发部(13333.33)→ 市场部(12000.00)→ 人事部(6500.00)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 6.分页查询
核心语法和示例
SELECT 字段 FROM 表名
[WHERE 条件]
[ORDER BY 字段]
LIMIT 起始索引, 每页条数;
-- 起始索引 = (页码 - 1) × 每页条数(第一页起始索引为0)


-- 示例:查询用户列表,按薪资降序排列,第二页(每页2条)
SELECT name, salary FROM users
ORDER BY salary DESC
LIMIT 2, 2;
-- 步骤拆解:
-- 1. 按薪资降序排序后的数据:周八(20000)→ 赵六(15000)→ 李四(12000)→ 王五(9000)→ 张三(8000)→ 吴九(7000)->孙七(6000)
-- 2. LIMIT 2,2:从索引2开始,取2条 → 李四(12000)、王五(9000)
-- 3.查第一页就是0,2,第二页2,2以此类推

-- 简化写法(第一页,起始索引可省略):LIMIT 2 → 等价于 LIMIT 0,2
SELECT name, salary FROM users ORDER BY salary DESC LIMIT 2;
-- 输出:周八(20000)、赵六(15000)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 执行顺序
SELECT 字段列表 FROM 表名列表 WHERE 条件列表 GROUP BY 分组字段列表
HAVING 分组后条件列表 ORDER BY 排序字段列表 LIMIT 分页参数
2
由前面可知编写顺序但是编写顺序却和执行顺序不一样,正确的执行顺序如下
FROM - 确定数据来源表
WHERE - 对原始数据进行筛选
GROUP BY - 对筛选后的数据进行分组
HAVING - 对分组后的数据进行筛选
SELECT - 选择要显示的字段
ORDER BY - 对最终结果进行排序
LIMIT - 限制返回的行数
# DCL(数据控制语言)
GRANT:为用户授予权限REVOKE:收回用户的权限
DCL主要有管理用户和权限控制两个内容
# 1.管理用户
1.查询用户
select * from mysql.user
结果如下
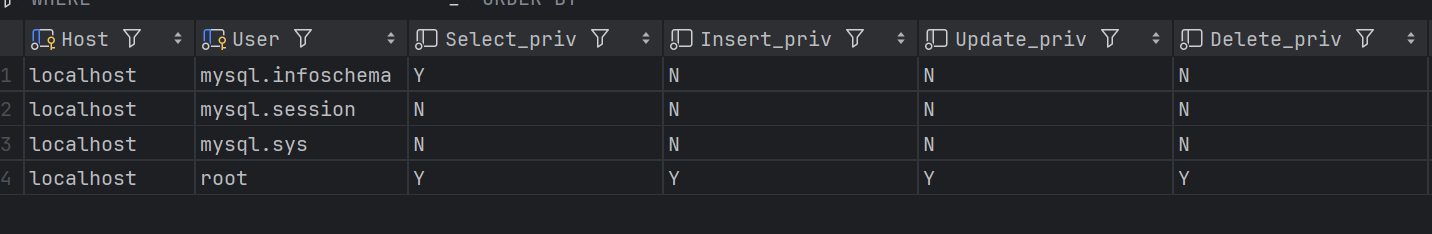
其中 Host代表当前用户访问的主机, 如果为localhost, 仅代表只能够在当前本机访问,是不可以远程访问的。 User代表的是访问该数据库的用户名。在MySQL中需要通过Host和User来唯一标识一个用户。
2.创建用户
CREATE USER '用户名'@'主机名' IDENTIFIED BY '密码'

-- 示例
-- 创建用户student, 只能够在当前主机localhost访问, 密码123456;

create user 'student'@'localhost' identified by '123456';

-- 创建用户teacher, 任意主机访问, 密码123456;

create user 'teacher'@'%' identified by '123456';
2
3
4
5
6
7
8
9
10
3.修改用户密码
ALTER USER '用户名'@'主机名' IDENTIFIED WITH mysql_native_password BY '新密码' ;

-- 修改teacher用户密码为1234
alter user 'teacher'@'%' identified with mysql_native_password by '1234';
--mysql_native_password的作用是将密码加密存储到用户表中(他是用户身份验证插件)
-- 当你进行校验时也是通过这个插件进行校验来比对数据库中存储的密码
2
3
4
5
6
4.删除用户
DROP USER '用户名'@'主机名' ;

-- 删除teacher用户
drop user 'teacher'@'%';
2
3
4
# 2.权限控制
MySql中定义了很多权限,最常用的是以下几种
| 权限 | 说明 |
|---|---|
| ALL, ALL PRIVILEGES | 所有权限 |
| SELECT | 查询数据 |
| INSERT | 插入数据 |
| UPDATE | 修改数据 |
| DELETE | 删除数据 |
| ALTER | 修改表 |
| DROP | 删除数据库/表/视图 |
| CREATE | 创建数据库/表 |
如果想了解更多可以去看官方文档 (opens new window)
1.查询权限
SHOW GRANTS FOR '用户名'@'主机名' ;

-- 查询用户student的权限
show grants for 'student'@'localhost' ;
-- GRANT USAGE ON *.* TO `student`@`localhost`
-- 表示没有权限
2
3
4
5
6
2.授予权限
GRANT 权限列表 ON 数据库名.表名 TO '用户名'@'主机名';
-- 授予用户student的所有表的所有权限
grant all on *.* to 'student'@'localhost';
show grants for 'student'@'localhost' ;
-- 查询结果后会显示大量的权限(select,insert等等)
2
3
4
5
3.撤销权限
REVOKE 权限列表 ON 数据库名.表名 FROM '用户名'@'主机名';

-- 撤销用户student的所有权限
revoke all on *.* from 'student'@'localhost';
show grants for 'student'@'localhost' ;
-- 查询后和第一条语句一样了
2
3
4
5
6
# 2.函数
MySQL中的函数主要分为以下四类: 字符串函数、数值函数、日期函数、流程函数。
# 2.1字符串函数
MySQL中内置了很多字符串函数,常用的几个如下:
| 函数 | 功能 |
|---|---|
| CONCAT(S1, S2, ...Sn) | 字符串拼接,将S1, S2, ... Sn拼接成一个字符串 |
| LOWER(str) | 将字符串str全部转为小写 |
| UPPER(str) | 将字符串str全部转为大写 |
| LPAD(str,n,pad) | 左填充,用字符串pad对str的左边进行填充,达到n个字符串长度 |
| RPAD(str,n,pad) | 右填充,用字符串pad对str的右边进行填充,达到n个字符串长度 |
| TRIM(str) | 去掉字符串头部和尾部的空格 |
| SUBSTRING(str,start,len) | 返回从字符串str从start位置起的len个长度的字符串 |
演示如下
# concat字符串拼接
select concat('Hello' , ' MySQL');#Hello MySQL
# lower : 全部转小写
select lower('Hello');#hello
# upper : 全部转大写
select upper('Hello');#HELLO
# lpad : 左填充
select lpad('01', 5, '-');#---01
# rpad : 右填充
select rpad('01', 5, '-');#01---
# trim : 去除空格
select trim(' Hello MySQL ');#Hello MySQL
# substring : 截取子字符串
select substring('Hello MySQL',1,5);#Hello
2
3
4
5
6
7
8
9
10
11
12
13
14
案例
由于业务需求变更,企业员工的工号,统一为5位数,目前不足5位数的全部在前面补0。
比如: 1号员工的工号应该为00001。
update employee set workno=lpad(workno,5,'0');
# 2.2数值函数
常见数值函数如下
| 函数 | 功能 |
|---|---|
| CEIL(x) | 向上取整 |
| FLOOR(x) | 向下取整 |
| MOD(x, y) | 返回x/y的模 |
| RAND() | 返回0~1内的随机数 |
| ROUND(x, y) | 求参数x的四舍五入的值,保留y位小数 |
演示如下
#向上取整
select ceil(1.1);#2
#向下取整
select floor(1.2);#1
#取模
select mod(3,2);#1
#0-1随机数
select rand();#0.15651243474009674(随机生成)
#求参数四舍五入值,保留y位小数
select round(2.344,2);#2.34
2
3
4
5
6
7
8
9
10
案例
通过数据库的函数,生成一个六位数的随机验证码。
思路: 获取随机数可以通过rand()函数,但是获取出来的随机数是在0-1之间的,所以可以在其基础上乘以1000000,然后舍弃小数部分,如果长度不足6位,补0
select lpad(round(rand()*1000000,0),6,0);
# 2.3日期函数
常见的日期函数如下
| 函数 | 功能 |
|---|---|
| CURDATE() | 返回当前日期 |
| CURTIME() | 返回当前时间 |
| NOW() | 返回当前日期和时间 |
| YEAR(date) | 获取指定date的年份 |
| MONTH(date) | 获取指定date的月份 |
| DAY(date) | 获取指定date的日期 |
| DATE_ADD(date, INTERVAL expr type) | 返回一个日期/时间值加上一个时间间隔expr后的时间值 |
| DATEDIFF(date1, date2) | 返回起始时间date1和结束时间date2之间的天数 |
演示
#返回当前日期
select curdate();
#返回当前时间
select curtime();
#返回当前日期和时间
select now();
#返回当前年月日
select year(now());
select month(now());
select day(now());
#返回日期加时间间隔
select date_add(now(),interval 30 year );#2056-02-01 12:59:12
#返回两个日期相隔天数
select datediff(now(),'2026-03-01 12:59:12');
2
3
4
5
6
7
8
9
10
11
12
13
14
案例
查询所有员工的入职天数,并根据入职天数倒序排序。
思路: 入职天数,就是通过当前日期 - 入职日期,所以需要使用datediff函数来完成。
select name,datediff(now(),entrydate) as workDay from employee
order by workDay desc;
2
# 2.4流程函数
流程函数也是很常用的一类函数,可以在SQL语句中实现条件筛选,从而提高语句的效率。
| 函数 | 功能 |
|---|---|
| IF(value, t, f) | 如果value为true,则返回t,否则返回f |
| IFNULL(value1, value2) | 如果value1不为空,返回value1,否则返回value2 |
| CASE WHEN [val1] THEN [res1] ... ELSE [default] END | 如果val1为true,返回res1,... 否则返回default默认值 |
| CASE [expr] WHEN [val1] THEN [res1] ... ELSE [default] END | 如果expr的值等于val1,返回res1,... 否则返回default默认值 |
演示
#if
select if(true,1,2);#1
#ifnull
select ifnull(1,2);#1
select ifnull('',2);#返回空
select ifnull(null,2);#2
#case when 调研用户是否成年
#建表语句可去1.4SQL语句下的DQL标题中去查找
SELECT
    name,
    CASE
        WHEN age < 18 THEN '未成年用户'
        WHEN age > 18 THEN '成年用户'
        ELSE '未知年龄用户'
    END AS '用户类型'
FROM users;
#case [expr] when 调研刚好成年的用户信息
SELECT
    name,
    CASE age
        WHEN 18 THEN '刚好成年用户'  -- 只能匹配age=18的情况
        ELSE '其他'
    END AS '用户类型'
FROM users;
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# 3.约束
# 3.1 概述
概念:约束是作用于表中字段上的规则,用于限制存储在表中的数据。
目的:保证数据库中数据的正确、有效性和完整性。
分类:
| 约束 | 描述 | 关键字 |
|---|---|---|
| 非空约束 | 限制该字段的数据不能为null | NOT NULL |
| 唯一约束 | 保证该字段的所有数据都是唯一、不重复的 | UNIQUE |
| 主键约束 | 主键是一行数据的唯一标识,要求非空且唯一 | PRIMARY KEY |
| 默认约束 | 保存数据时,如果未指定该字段的值,则采用默认值 | DEFAULT |
| 检查约束(8.0.16版本之后) | 保证字段值满足某一个条件 | CHECK |
| 外键约束 | 用来让两张表的数据之间建立连接,保证数据的一致性和完整性 | FOREIGN KEY |
# 3.2 约束演示
案例需求: 根据需求,完成表结构的创建。需求如下:
| 字段名 | 含义 | 字段类型 | 约束条件 | 约束关键字 |
|---|---|---|---|---|
| id | ID唯一标识 | int | 主键,并且自动增长 | PRIMARY KEY, AUTO_INCREMENT |
| name | 姓名 | varchar(10) | 不为空,并且唯一 | NOT NULL, UNIQUE |
| age | 年龄 | int | 大于0,并且小于等于120 | CHECK |
| status | 状态 | char(1) | 如果没有指定该值,默认为1 | DEFAULT |
| gender | 性别 | char(1) | 无 | 无 |
对应建表语句
create table tb_user(
    id int auto_increment primary key comment 'id唯一标识',
    name varchar(10) not null unique comment '姓名',
    age int check ( age>0 && age<=120 ) comment '年龄',
    status char(1) default 1 comment '状态',
    gender char(1) comment '性别'
);
2
3
4
5
6
7
可以加个数据测试一下约束是否生效
insert into tb_user(name,age,status,gender) values ('Tom1',19,'1','男'),
('Tom2',25,'0','男');
insert into tb_user(name,age,status,gender) values ('Tom3',19,'1','男');
insert into tb_user(name,age,status,gender) values (null,19,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom3',19,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom4',80,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom5',-1,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom5',121,'1','男');
insert into tb_user(name,age,gender) values ('Tom5',120,'男');
2
3
4
5
6
7
8
9
# 3.3外键约束
# 1.介绍
外键:用来让两张表的数据之间建立连接,从而保证数据的一致性和完整性。
来看案例
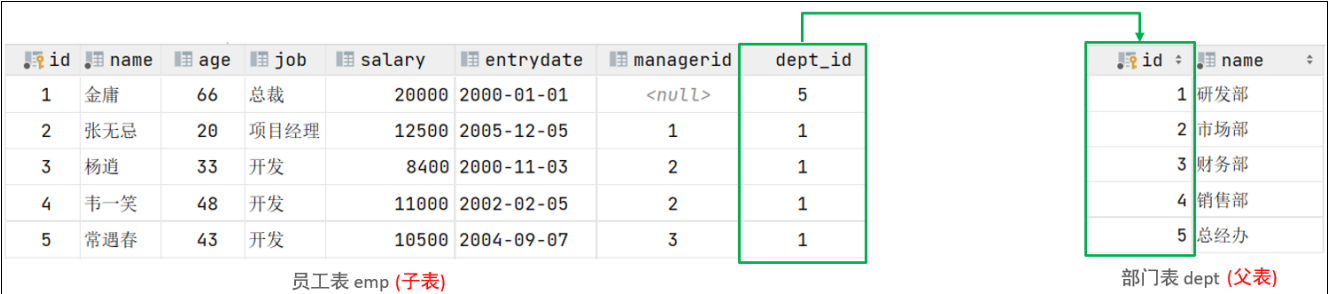
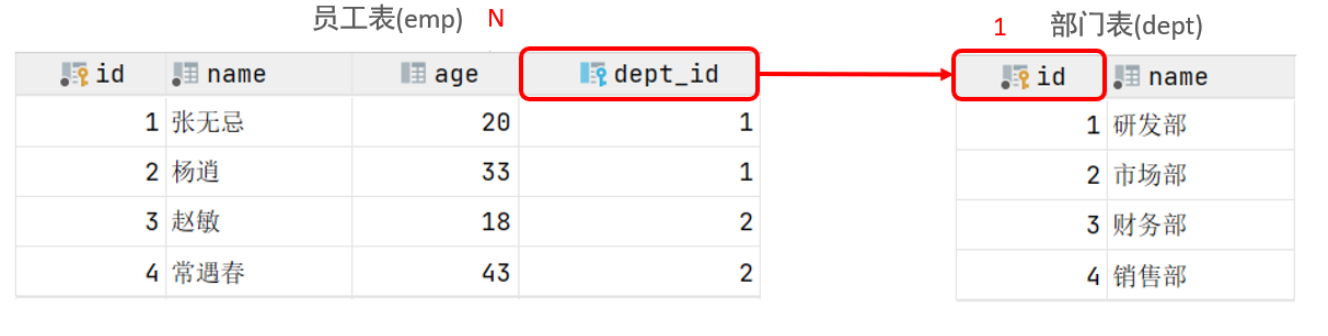
左侧的emp表是员工表,里面存储员工的基本信息,包含员工的ID、姓名、年龄、职位、薪资、入职日期、上级主管ID、部门ID,在员工的信息中存储的是部门的ID dept_id,而这个部门的ID是关联的部门表dept的主键id,那emp表的dept_id就是外键,关联的是另一张表的主键。
注意:目前上述两张表,只是在逻辑上存在这样一层关系;在数据库层面,并未建立外键关联,所以是无法保证数据的一致性和完整性的。
没有数据库外键关联的情况下,能够保证一致性和完整性呢,我们来测试一下。
准备数据
create table dept(
id int auto_increment comment 'ID' primary key,
name varchar(50) not null comment '部门名称'
)comment '部门表';
INSERT INTO dept (id, name) VALUES (1, '研发部'), (2, '市场部'),(3, '财务部'), (4,
'销售部'), (5, '总经办');
create table emp(
id int auto_increment comment 'ID' primary key,
name varchar(50) not null comment '姓名',
age int comment '年龄',
job varchar(20) comment '职位',
salary int comment '薪资',
entrydate date comment '入职时间',
managerid int comment '直属领导ID',
dept_id int comment '部门ID'
#foreign key (dept_id) references dept(id)
)comment '员工表';
INSERT INTO emp (id, name, age, job,salary, entrydate, managerid, dept_id)
VALUES
(1, '金庸', 66, '总裁',20000, '2000-01-01', null,5),(2, '张无忌', 20,
'项目经理',12500, '2005-12-05', 1,1),
(3, '杨逍', 33, '开发', 8400,'2000-11-03', 2,1),(4, '韦一笑', 48, '开
发',11000, '2002-02-05', 2,1),
(5, '常遇春', 43, '开发',10500, '2004-09-07', 3,1),(6, '小昭', 19, '程
序员鼓励师',6600, '2004-10-12', 2,1);
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
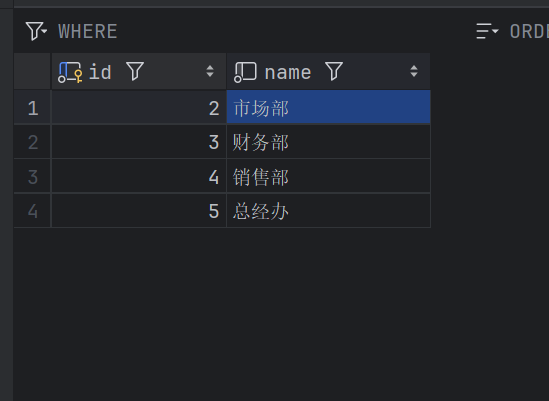
可以尝试删除部门表中的id为1的研发部,发现是可以删除的,而删除成功之后,部门表不存在id为1的部门,而在emp表中还有很多的员工,关联的为id为1的部门,此时就出现了数据的不完整性。 而要想解决这个问题就得通过数据库的外键约束。
# 2.语法
添加外键
CREATE TABLE 表名(
字段名 数据类型,
...
[CONSTRAINT] [外键名称] FOREIGN KEY (外键字段名) REFERENCES 主表 (主表列名)
);

--示例
create table emp(
id int auto_increment comment 'ID' primary key,
name varchar(50) not null comment '姓名',
age int comment '年龄',
job varchar(20) comment '职位',
salary int comment '薪资',
entrydate date comment '入职时间',
managerid int comment '直属领导ID',
dept_id int comment '部门ID'
foreign key (dept_id) references dept(id)
)comment '员工表';

-- 在已建表的基础上添加
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段名)
REFERENCES 主表 (主表列名) ;

-- 示例 为emp表的dept_id字段添加外键约束,关联dept表的主键id。
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references
dept(id);
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
删除外键
ALTER TABLE 表名 DROP FOREIGN KEY 外键名称;
-- 示例
alter table emp drop foreign key fk_emp_dept_id;
2
3
# 3.删除或更新操作
添加了外键之后,再删除父表数据时产生的约束行为,我们就称为删除/更新行为。具体的删除/更新行为有以下几种:
| 行为 | 说明 |
|---|---|
| NO ACTION | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更新。(与 RESTRICT 一致)默认行为 |
| RESTRICT | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更新。(与 NO ACTION 一致)默认行为 |
| CASCADE | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则同步删除/更新子表中的对应记录 |
| SET NULL | 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则设置子表中该外键值为 null(这就要求该外键允许取 null) |
| DEFAULT | 父表有变更时,子表将外键列设置成一个默认的值(Innodb不支持) |
cascade具体语法为:
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段) REFERENCES
主表名 (主表字段名) ON UPDATE CASCADE ON DELETE CASCADE;
2
cascade示例:
alter table emp add constraint fk_emp_dept_id
    foreign key (dept_id) references dept(id)
    on update  cascade  on DELETE  cascade;
2
3
简而言之就是同步更新或删除
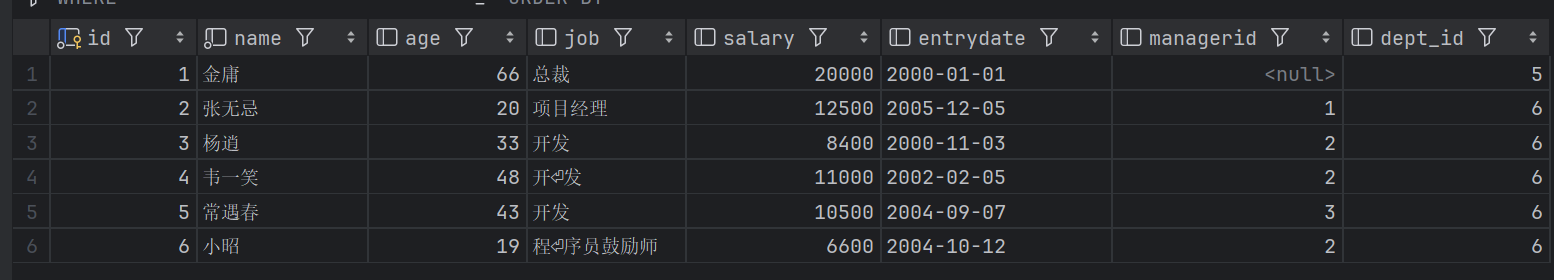
可以将dept表中的id为1的部门修改id为6测试,发现emp中dept_id原来是1的数据变为6
将id为6的部门删除时,发现emp表中部门id为6的数据也被删除
注意:在测试setnull之前我们先将数据恢复
setnull示例:
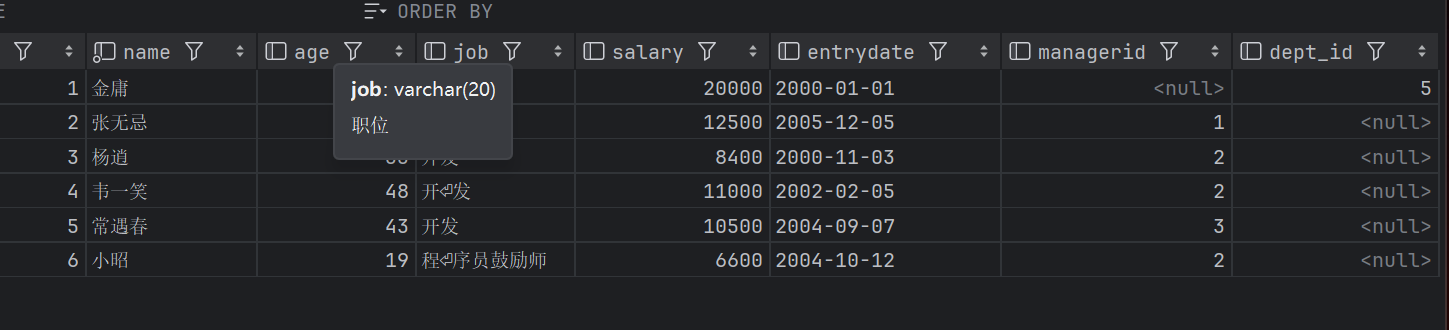
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references
dept(id) on update set null on delete set null ;
2
删除dept中id为1的部门结果emp中dept_id中id为1的数据变为空
# 4.多表查询
# 4.1 多表关系
项目开发中,在进行数据库表结构设计时,会根据业务需求及业务模块之间的关系,分析并设计表结构,由于业务之间相互关联,所以各个表结构之间也存在着各种联系,基本上分为三种:
一对多(多对一)
多对多
一对一
# 1.一对多
案例: 部门 与 员工的关系
关系: 一个部门对应多个员工,一个员工对应一个部门
实现: 在多的一方建立外键,指向一的一方的主键
# 2.多对多
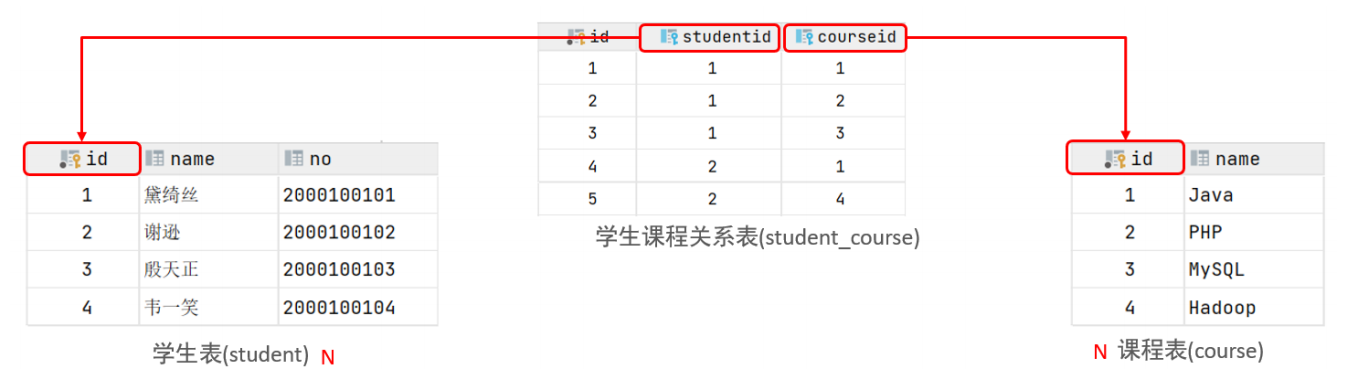
案例: 学生 与 课程的关系
关系: 一个学生可以选修多门课程,一门课程也可以供多个学生选择
实现: 建立第三张中间表,中间表至少包含两个外键,分别关联两方主键
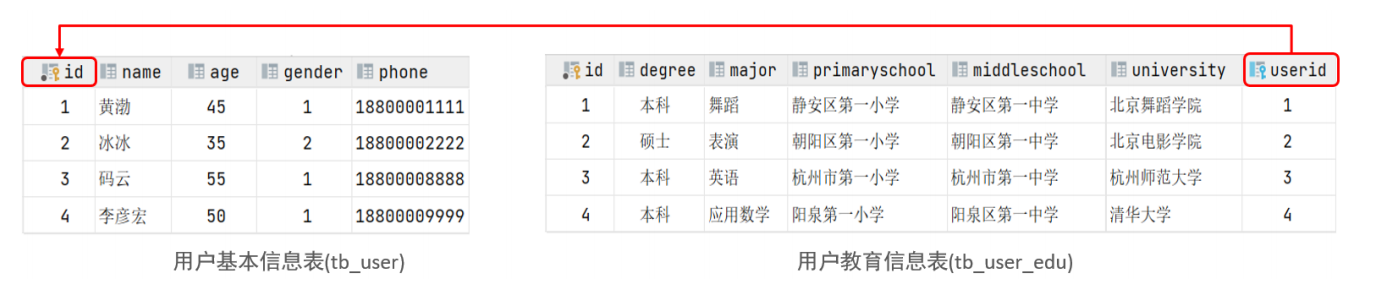
# 3. 一对一
案例: 用户 与 用户详情的关系
关系: 一对一关系,多用于单表拆分,将一张表的基础字段放在一张表中,其他详情字段放在另一张表中,以提升操作效率
实现: 在任意一方加入外键,关联另外一方的主键,并且设置外键为唯一的(UNIQUE)
# 4.2 概述
# 1. 定义
多表查询是指从两张或两张以上的数据表中检索数据的查询方式,是 SQL 查询的核心应用场景之一。当单张表无法满足业务数据需求(如订单表关联用户表、商品表)时,需要通过多表查询整合关联数据。
# 2. 核心前提
多表查询的关键是找到表之间的关联字段(通常是主键 / 外键关系),否则会产生 “笛卡尔积”(两张表数据无意义的全量组合),导致查询结果错误。
示例(笛卡尔积问题):
-- 假设员工表有3条数据,部门表有5条数据,结果会返回15条无意义数据
SELECT * FROM emp, dept;
2
# 3.分类
1.连接查询:
内连接:相当于查询两个表交集部分数据
外连接:
左外连接:查询左表所有数据,以及两张表交集部分数据
右外连接:查询右表所有数据,以及两张表交集部分数据
自连接:当前表与自身的连接查询,自连接必须使用表别名
2.子查询
# 4.数据准备
创建新的emp和dept表
-- 创建dept表,并插入数据
create table dept(
id int auto_increment comment 'ID' primary key,
name varchar(50) not null comment '部门名称'
)comment '部门表';
INSERT INTO dept (id, name) VALUES (1, '研发部'), (2, '市场部'),(3, '财务部'), (4,
'销售部'), (5, '总经办'), (6, '人事部');
-- 创建emp表,并插入数据
create table emp(
id int auto_increment comment 'ID' primary key,
name varchar(50) not null comment '姓名',
age int comment '年龄',
job varchar(20) comment '职位',
salary int comment '薪资',
entrydate date comment '入职时间',
managerid int comment '直属领导ID',
dept_id int comment '部门ID'
)comment '员工表';
-- 添加外键
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references
dept(id);
INSERT INTO emp (id, name, age, job,salary, entrydate, managerid, dept_id)
VALUES
(1, '金庸', 66, '总裁',20000, '2000-01-01', null,5),
(2, '张无忌', 20, '项目经理',12500, '2005-12-05', 1,1),
(3, '杨逍', 33, '开发', 8400,'2000-11-03', 2,1),
(4, '韦一笑', 48, '开发',11000, '2002-02-05', 2,1),
(5, '常遇春', 43, '开发',10500, '2004-09-07', 3,1),
(6, '小昭', 19, '程序员鼓励师',6600, '2004-10-12', 2,1),
(7, '灭绝', 60, '财务总监',8500, '2002-09-12', 1,3),
(8, '周芷若', 19, '会计',48000, '2006-06-02', 7,3),
(9, '丁敏君', 23, '出纳',5250, '2009-05-13', 7,3),
(10, '赵敏', 20, '市场部总监',12500, '2004-10-12', 1,2),
(11, '鹿杖客', 56, '职员',3750, '2006-10-03', 10,2),
(12, '鹤笔翁', 19, '职员',3750, '2007-05-09', 10,2),
(13, '方东白', 19, '职员',5500, '2009-02-12', 10,2),
(14, '张三丰', 88, '销售总监',14000, '2004-10-12', 1,4),
(15, '俞莲舟', 38, '销售',4600, '2004-10-12', 14,4),
(16, '宋远桥', 40, '销售',4600, '2004-10-12', 14,4),
(17, '陈友谅', 42, null,2000, '2011-10-12', 1,null);
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
# 4.3内连接
# 1. 定义
内连接(INNER JOIN)只返回多张表中满足关联条件的交集数据,不满足条件的记录会被过滤。
# 2. 语法(两种写法)
-- 写法1:显式内连接(推荐,可读性更高)
SELECT 字段列表
FROM 表1
INNER JOIN 表2
ON 表1.关联字段 = 表2.关联字段
[WHERE 筛选条件];

-- 写法2:隐式内连接(传统写法,通过WHERE指定关联条件)
SELECT 字段列表
FROM 表1, 表2
WHERE 表1.关联字段 = 表2.关联字段
[AND 筛选条件];
2
3
4
5
6
7
8
9
10
11
12
案例:
1.查询每一个员工的姓名 , 及关联的部门的名称 (显式内连接实现) --- INNER JOIN ...ON
select e.name, d.name from emp e inner join dept d on e.dept_id = d.id;
2.查询每一个员工的姓名 , 及关联的部门的名称 (隐式内连接实现)
select e.name,d.name from emp e , dept d where e.dept_id = d.id;
# 4.4外连接
# 1. 定义
外连接会返回一张表的全部记录,以及另一张表满足关联条件的记录;不满足条件的部分会填充NULL。
# 2. 分类及语法
1.左外连接(LEFT JOIN)
返回左表的所有记录 + 右表匹配的记录,右表无匹配则填NULL。
sql
SELECT 字段列表
FROM 左表
LEFT [OUTER] JOIN 右表
ON 关联条件
[WHERE 筛选条件];
2
3
4
5
2.右外连接(RIGHT JOIN)
返回右表的所有记录 + 左表匹配的记录,左表无匹配则填NULL。
SELECT 字段列表
FROM 左表
RIGHT [OUTER] JOIN 右表
ON 关联条件
[WHERE 筛选条件];
2
3
4
5
案例:
1.查询emp表的所有数据, 和对应的部门信息
select e.*, d.name from emp e left join dept d on e.dept_id = d.id;
2.查询dept表的所有数据, 和对应的员工信息(右外连接)
select d.*, e.* from dept d left join emp e on e.dept_id = d.id;
注意:左外连接和右外连接是可以相互替换的,只需要调整在连接查询时SQL中,表结构的先后顺序就可以了。而我们在日常开发使用时,更偏向于左外连接。
# 4.5自连接
# 1. 定义
自连接是指将同一张表视为两张独立的表进行连接查询,本质是内连接 / 外连接的特殊应用(关联字段来自同一张表)。
# 2. 核心前提
需为同一张表起不同的别名,避免字段冲突。
# 3. 语法
SELECT 字段列表
FROM 表名 别名1
[INNER/LEFT/RIGHT] JOIN 表名 别名2
ON 别名1.字段 = 别名2.字段
[WHERE 筛选条件];
2
3
4
5
案例:
1.查询员工及其所属领导的名字
select a.name , b.name from emp a , emp b where a.managerid = b.id;
2.查询所有员工 emp 及其领导的名字 emp , 如果员工没有领导, 也需要查询出来
select a.name '员工', b.name '领导' from emp a left join emp b on a.managerid =b.id;
注意:在自连接查询中,必须要为表起别名,要不然我们不清楚所指定的条件、返回的字段,到底是哪一张表的字段。
# 4.6联合查询
# 1. 定义
联合查询是指将多个 SELECT 语句的结果集合并为一个结果集,适用于 “同结构数据、不同条件” 的查询场景(如合并不同时间段的订单)。
# 2. 语法
sql
-- UNION:合并结果并去重
SELECT 字段列表 FROM 表1 [WHERE 条件]
UNION
SELECT 字段列表 FROM 表2 [WHERE 条件];

-- UNION ALL:合并结果但不去重(效率更高)
SELECT 字段列表 FROM 表1 [WHERE 条件]
UNION ALL
SELECT 字段列表 FROM 表2 [WHERE 条件];
2
3
4
5
6
7
8
9
# 3. 核心规则
- 多个 SELECT 语句的字段数量、字段类型、字段顺序必须一致;
- UNION 会自动去重(性能略低),UNION ALL 保留所有记录(推荐优先使用,除非需要去重)。
案例
将薪资低于 5000 的员工 , 和 年龄大于 50 岁的员工全部查询出来.
select * from emp where salary < 5000
union all
select * from emp where age > 50;
2
3
去重
select * from emp where salary < 5000
union
select * from emp where age > 50;
2
3
注意:如果多条查询语句查询出来的结果,字段数量不一致,在进行union/union all联合查询时,将会报错。
# 4.7子查询
# 1. 子查询介绍
# (1)定义
子查询(嵌套查询)是指在一个 SELECT 语句中嵌套另一个 SELECT 语句,内层查询的结果作为外层查询的条件 / 数据源。
# (2)语法结构
-- 外层查询
SELECT 字段列表
FROM 表名
WHERE 字段 运算符 (
    -- 子查询(内层查询)
    SELECT 字段列表 FROM 表名 WHERE 条件
);
2
3
4
5
6
7
# (3)特点
- 子查询需用
()包裹; - 执行顺序:先执行内层子查询,再执行外层查询;
- 可根据子查询结果的类型,分为标量、列、行、表子查询。
# 2. 标量子查询
# (1)定义
子查询返回的结果是单个值(一行一列(数字、字符串、日期等)),可直接用=、>、<、>=、<=、<> 等运算符判断。
# (2)示例
需求:查询 "销售部" 的所有员工信息
select * from emp where dept_id = (select id from dept where name = '销售部');
# 3. 列子查询
# (1)定义
子查询返回的结果是一列多行,需用IN、NOT IN、ANY、ALL等运算符。
# (2)常用运算符
IN:匹配列表中的任意一个值;NOT IN:不匹配列表中的任何值;ANY:满足列表中任意一个条件(如> ANY(列表):大于列表中任意一个值);ALL:满足列表中所有条件(如> ALL(列表):大于列表中所有值)。
# (3)示例
需求:查询 "销售部" 和 "市场部" 的所有员工信息
select * from emp where dept_id in (select id from dept where name = '销售部' or
name = '市场部');
2
# 4. 行子查询
# (1)定义
子查询返回的结果是一行多列,需将多个字段作为整体判断(用=、IN等)。
# (2)示例
需求:查询与 "张无忌" 的薪资及直属领导相同的员工信息 ;
select * from emp where (salary,managerid) = (select salary, managerid from emp
where name = '张无忌');
2
# 5. 表子查询
# (1)定义
子查询返回的结果是多行多列(一张临时表),通常用于FROM子句(需给临时表起别名)。
# (2)示例
需求:查询每个部门的订单数(先关联用户和订单表,再按部门分组)
select * from emp where (job,salary) in ( select job, salary from emp where name =
'鹿杖客' or name = '宋远桥' );
2
# 5.事务
# 5.1事务简介
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败。
就比如: 张三给李四转账1000块钱,张三银行账户的钱减少1000,而李四银行账户的钱要增加1000。 这一组操作就必须在一个事务的范围内,要么都成功,要么都失败。
# 5.2事务操作
# 1.失败案例
数据准备
create table account(
id int primary key AUTO_INCREMENT comment 'ID',
name varchar(10) comment '姓名',
money double(10,2) comment '余额'
) comment '账户表';
insert into account(name, money) VALUES ('张三',2000), ('李四',2000);
2
3
4
5
6
前提说明:张三给李四转1000元,张三余额-1000,李四余额+1000
测试正常情况
-- 1. 查询张三余额
select * from account where name = '张三';
-- 2. 张三的余额减少1000
update account set money = money - 1000 where name = '张三';
-- 3. 李四的余额增加1000
update account set money = money + 1000 where name = '李四';
2
3
4
5
6
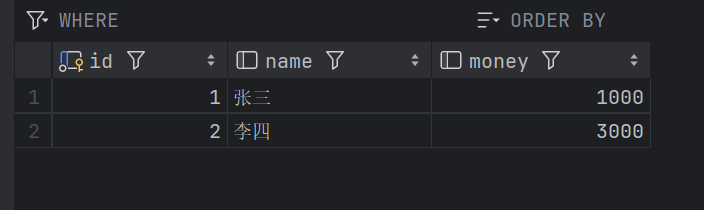
将数据恢复测试失败情况
-- 1. 查询张三余额
select * from account where name = '张三';
-- 2. 张三的余额减少1000
update account set money = money - 1000 where name = '张三';
出错了出错了....update lalala;....
-- 3. 李四的余额增加1000
update account set money = money + 1000 where name = '李四';
2
3
4
5
6
7
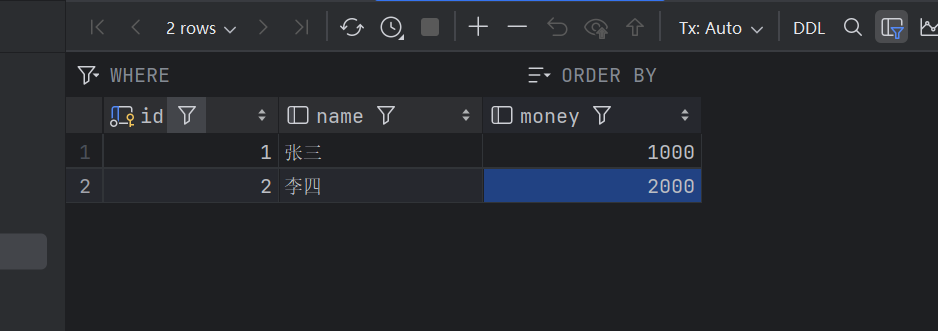
可以看到由于未开启事务只有没有执行到最后一条语句,导致了数据和我们的预期不一致
# 2.控制事务
方式一:
(1). 查看/设置事务提交方式
SELECT @@autocommit ;

SET @@autocommit = 0 ;
2
3
(2). 提交事务
commit;
(3).回滚事务
rollback;
注意:上述的这种方式,我们是修改了事务的自动提交行为, 把默认的自动提交修改为了手动提交, 此时我们执行的DML语句都不会提交, 需要手动的执行commit进行提交。
方式二:
(1)开启事务
start transaction ;#或者begin
(2)提交事务
commit;
(3).回滚事务
rollback;
转账示例
-- 开启事务
start transaction
-- 1. 查询张三余额
select * from account where name = '张三';
-- 2. 张三的余额减少1000
update account set money = money - 1000 where name = '张三';
-- 3. 李四的余额增加1000
update account set money = money + 1000 where name = '李四';
-- 如果正常执行完毕, 则提交事务
commit;
-- 如果执行过程中报错, 则回滚事务
-- rollback;
2
3
4
5
6
7
8
9
10
11
12
# 5.3事务的四大特性
| 特性 | 英文 | 含义 |
|---|---|---|
| 原子性 | Atomicity | 事务中的所有操作是一个整体,要么全执行,要么全不执行,不可拆分。 |
| 一致性 | Consistency | 事务执行前后,必须使所有数据状态保持一致 |
| 隔离性 | Isolation | 多个并发事务之间相互隔离,一个事务的操作不会被其他事务干扰。 |
| 持久性 | Durability | 事务一旦提交成功,修改会永久保存到数据库,即使数据库崩溃也不会丢失。 |
示例理解 ACID:
以转账为例(A 转 100 元给 B):
- 原子性:A 扣款、B 加款要么都执行,要么都不执行(不会出现 A 扣了钱但 B 没收到);
- 一致性:转账前后,A+B 的总金额不变;
- 隔离性:A、B 转账的同时,其他事务查看到的金额是 “要么转前、要么转后”,不会看到中间状态;
- 持久性:转账提交后,即使数据库重启,A 和 B 的余额仍为最终结果。
# 5.4事务的隔离级别
# 1. 定义
隔离级别决定了多个并发事务之间的隔离程度,级别越低,并发性能越好,但数据一致性越差;级别越高,一致性越好,但性能越低。
# 2. 并发事务的问题
| 问题 | 含义 |
|---|---|
| 脏读 | 一个事务读取到另一个事务未提交的修改数据(可能被回滚,数据无效)。 |
| 不可重复读 | 一个事务内多次读取同一数据,期间被其他事务修改并提交,导致读取结果不一致。 |
| 幻读 | 一个事务按照条件查询数据时,没有对应的数据行,但是在插入数据时,又发现这行数据已经存在(其他事务操作),好像出现了 "幻影"。 |
# 3. MySQL 的 4 种隔离级别(从低到高)
| 隔离级别 | 英文 | 脏读 | 不可重复读 | 幻读 | 特点 |
|---|---|---|---|---|---|
| 读未提交 | READ UNCOMMITTED | ✅ | ✅ | ✅ | 性能最高,一致性最差,几乎不使用。 |
| 读已提交 | READ COMMITTED | ❌ | ✅ | ✅ | 解决脏读,Oracle 默认级别,多数互联网场景使用。 |
| 可重复读 | REPEATABLE READ | ❌ | ❌ | ✅ | 解决脏读、不可重复读,MySQL 默认级别 |
| 串行化 | SERIALIZABLE | ❌ | ❌ | ❌ | 完全串行执行事务,一致性最好,性能最差(锁表),仅用于严格一致性场景。 |
# 4. 隔离级别操作
-- 查看当前会话隔离级别
SELECT @@TRANSACTION_ISOLATION;


-- 设置当前会话隔离级别
SET [ SESSION | GLOBAL ] TRANSACTION ISOLATION LEVEL { READ UNCOMMITTED |
READ COMMITTED | REPEATABLE READ | SERIALIZABLE }
2
3
4
5
6
7
注意:事务隔离级别越高,数据越安全,但是性能越低。