# SQL优化
# 1.插入数据
insert into tb_test values(1,'tom');
insert into tb_test values(2,'cat');
insert into tb_test values(3,'jerry');
2
3
1.优化方案一:批量插入数据
Insert into tb_test values(1,'Tom'),(2,'Cat'),(3,'Jerry');
2.优化方案二:手动控制事务
start transaction;
insert into tb_test values(1,'Tom'),(2,'Cat'),(3,'Jerry');
insert into tb_test values(4,'Tom'),(5,'Cat'),(6,'Jerry');
insert into tb_test values(7,'Tom'),(8,'Cat'),(9,'Jerry');
commit;
2
3
4
5
3.优化方案三:主键顺序插入,性能要高于乱序插入。
大批量插入数据
如果一次性需要插入大批量数据(比如: 几百万的记录),使用insert语句插入性能较低,此时可以使用MySQL数据库提供的load指令进行插入。操作如下:
-- 客户端连接服务端时,加上参数 -–local-infile
mysql –-local-infile -u root -p
-- 设置全局参数local_infile为1,开启从本地加载文件导入数据的开关
set global local_infile = 1;
-- 执行load指令将准备好的数据,加载到表结构中
load data local infile '/root/sql1.log' into table tb_user fields
terminated by ',' lines terminated by '\n' ;
2
3
4
5
6
7
示例:
在test_one中创建表结构
CREATE TABLE `tb_user` (
`id` INT(11) NOT NULL AUTO_INCREMENT,
`username` VARCHAR(50) NOT NULL,
`password` VARCHAR(50) NOT NULL,
`name` VARCHAR(20) NOT NULL,
`birthday` DATE DEFAULT NULL,
`sex` CHAR(1) DEFAULT NULL,
PRIMARY KEY (`id`),
UNIQUE KEY `unique_user_username` (`username`)
) ENGINE=INNODB DEFAULT CHARSET=utf8 ;
2
3
4
5
6
7
8
9
10
设置参数
-- 查询是否开启
select @@local_infile;
-- 客户端连接服务端时,加上参数 -–local-infile
set global  local_infile=1;
-- 退出重连连接时设置连接参数
mysql -u root -p –-local-infile=1;
2
3
4
5
6
load加载数据
load data local infile '/root/load_user_100w_sort.sql' into table tb_user
fields terminated by ',' lines terminated by '\n' ;
2
# 2.主键优化
分析主键顺序插入的性能是要高于乱序插入的具体原因
前情回顾
在InnoDB存储引擎中,表数据都是根据主键顺序组织存放的,这种存储方式的表称为索引组织表
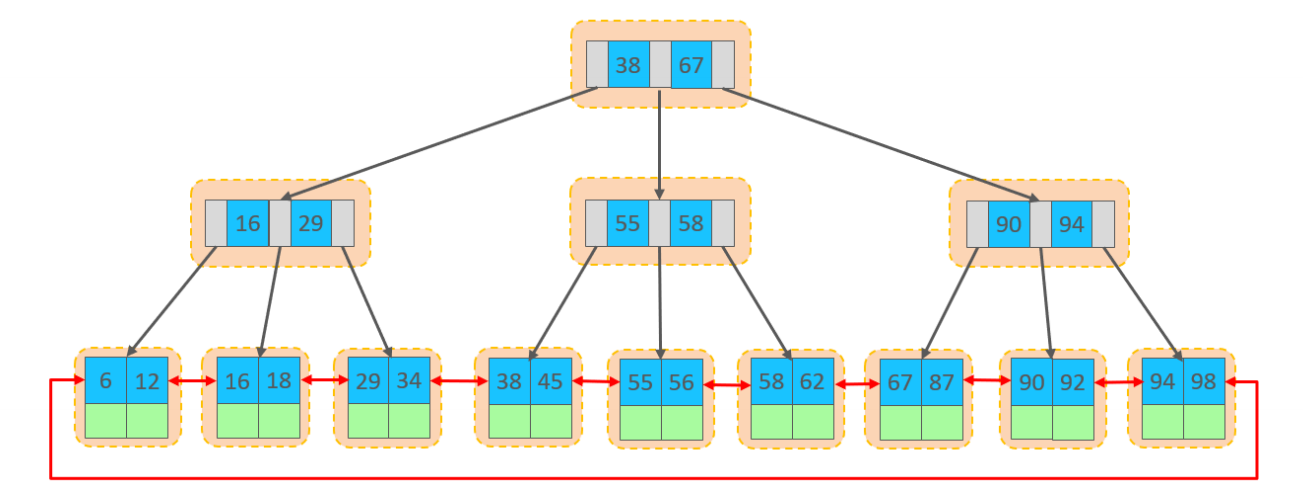
行数据,都是存储在聚集索引的叶子节点上的。而我们之前也讲解过InnoDB的逻辑结构图:
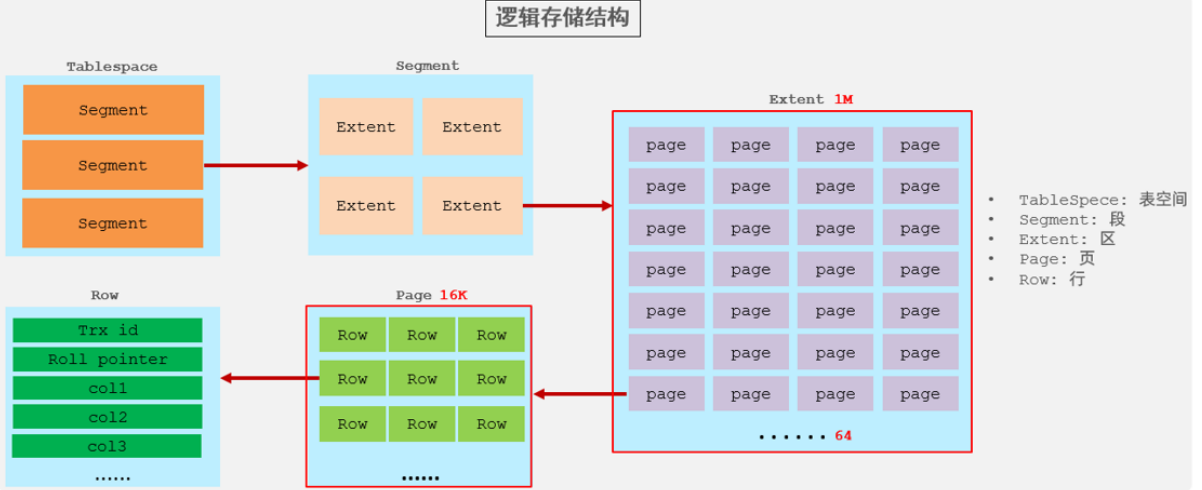
在InnoDB引擎中,数据行是记录在逻辑结构 page 页中的,而每一个页的大小是固定的,默认16K。那也就意味着, 一个页中所存储的行也是有限的,如果插入的数据行row在该页存储不小,将会存储到下一个页中,页与页之间会通过指针连接。
1.页分裂
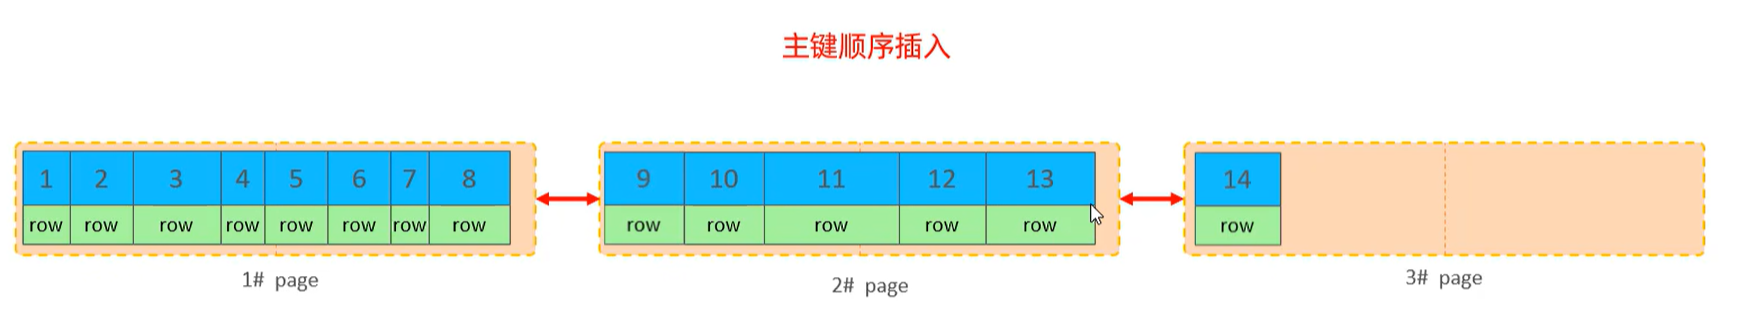
页可以为空,也可以填充一半,也可以填充100%。每个页包含了2~N行数据(如果一行数据过大,会行溢出),根据主键排列。
主键顺序插入
主键乱序插入
例如下一个插入50
初始状态:
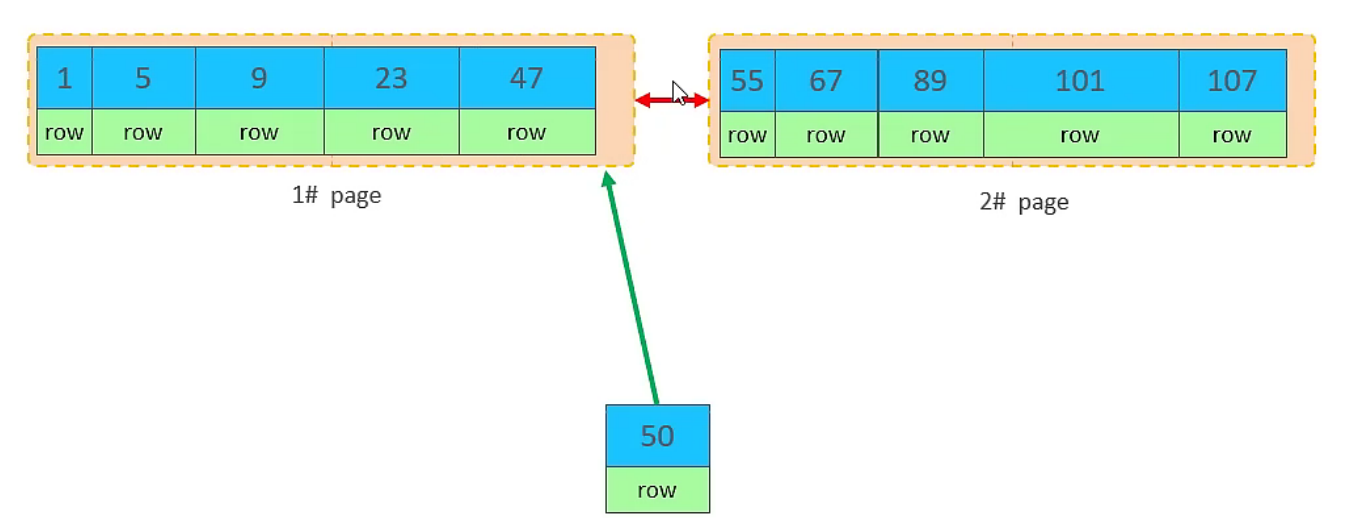
按理说应该插入47后面,但是47已满,插入50创建新页:
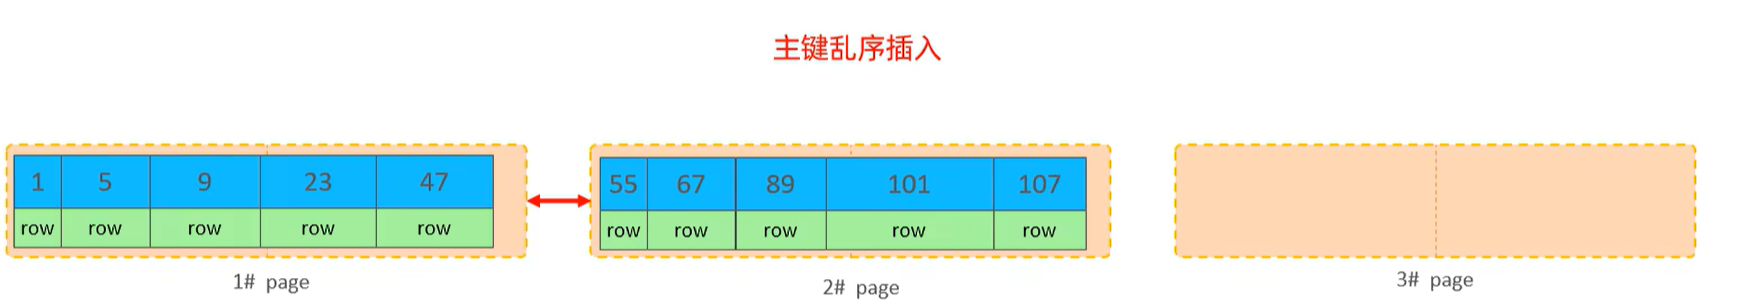
不会直接存入50到第三页,将1的后半段移动到3,然后在第三页插入50:
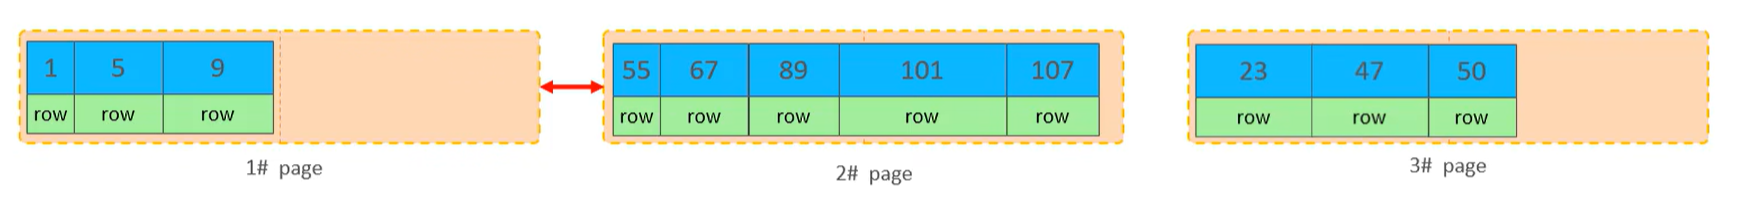
然后再按顺序排序重置链表指针:
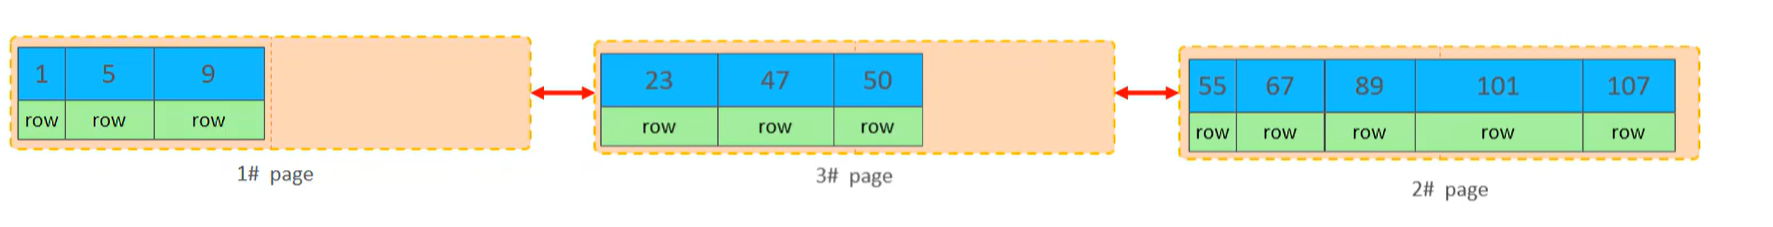
上述的这种现象,称之为 "页分裂",是比较耗费性能的操作。
2.页合并
初始状态:
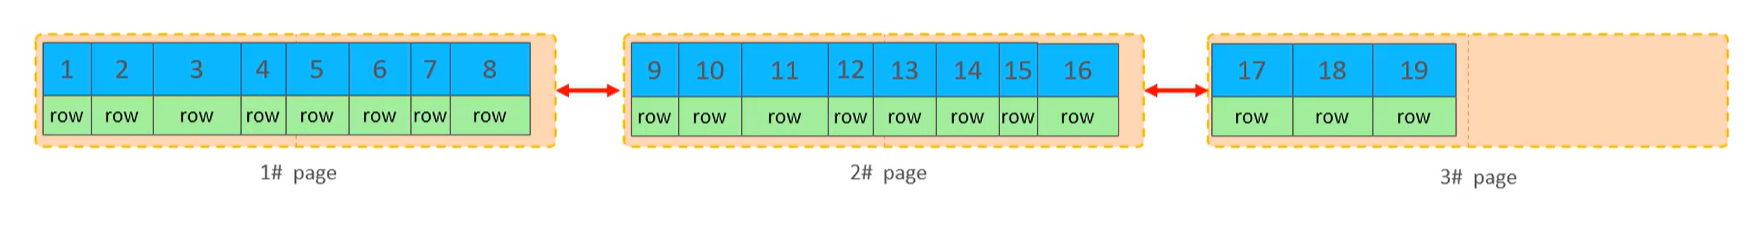
现删除16,但记录并没有被物理删除,只是记录被标记(flaged)为删除并且它的空间
变得允许被其他记录声明使用:
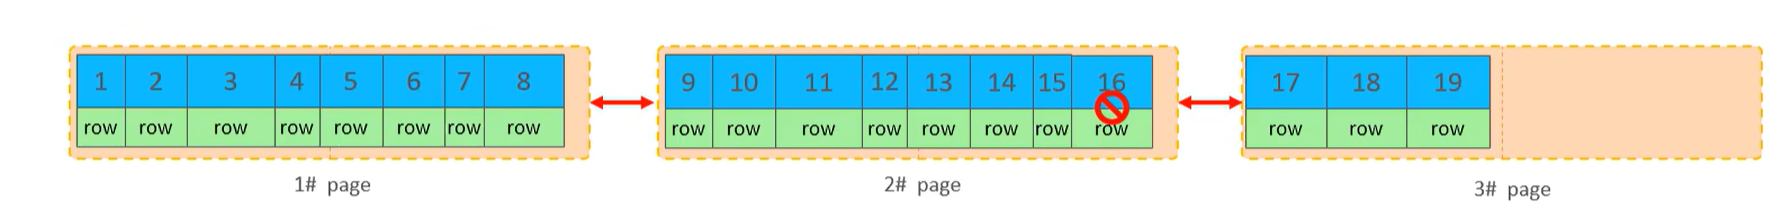
当删除13,14,15,16,超出删除页的默认阈值(MERGE_THRESHOLD)百分之50时,会触发合并操作:
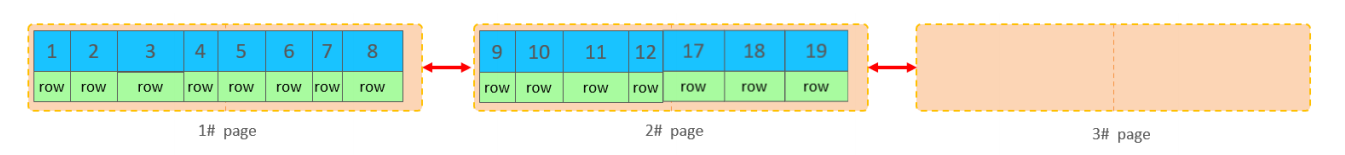
再插入21时,直接插入到3
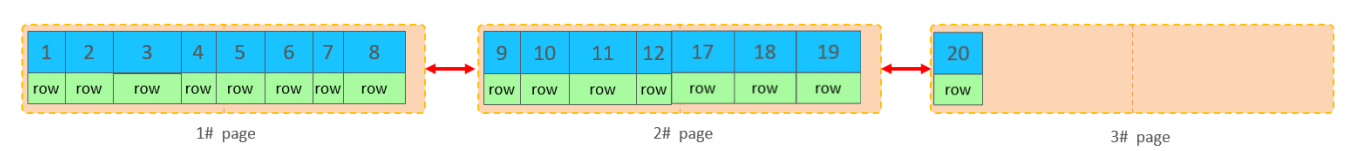
MERGE_THRESHOLD:合并页的阈值,可以自己设置,在创建表或者创建索引时指定
3.索引插入原则
满足业务需求的情况下,尽量降低主键的长度。(避免二级索引查询数据不够用,需要查询聚集索引时性能降低)
插入数据时,尽量选择顺序插入,选择使用AUTO_INCREMENT自增主键。尽量不要使用UUID做主键或者是其他自然主键,如身份证号。(避免乱序插入,产生页分裂,另外主键过长性能也会降低)
业务操作时,避免对主键的修改。(防止连带的二级索引也需修改而产生混乱)
# 3.Order By优化
MySQL的排序,有两种方式:
Using filesort : 通过表的索引或全表扫描,读取满足条件的数据行,然后在排序缓冲区sort
buffer中完成排序操作,所有不是通过索引直接返回排序结果的排序都叫 FileSort 排序。
Using index : 通过有序索引顺序扫描直接返回有序数据,这种情况即为 using index,不需要额外排序,操作效率高。
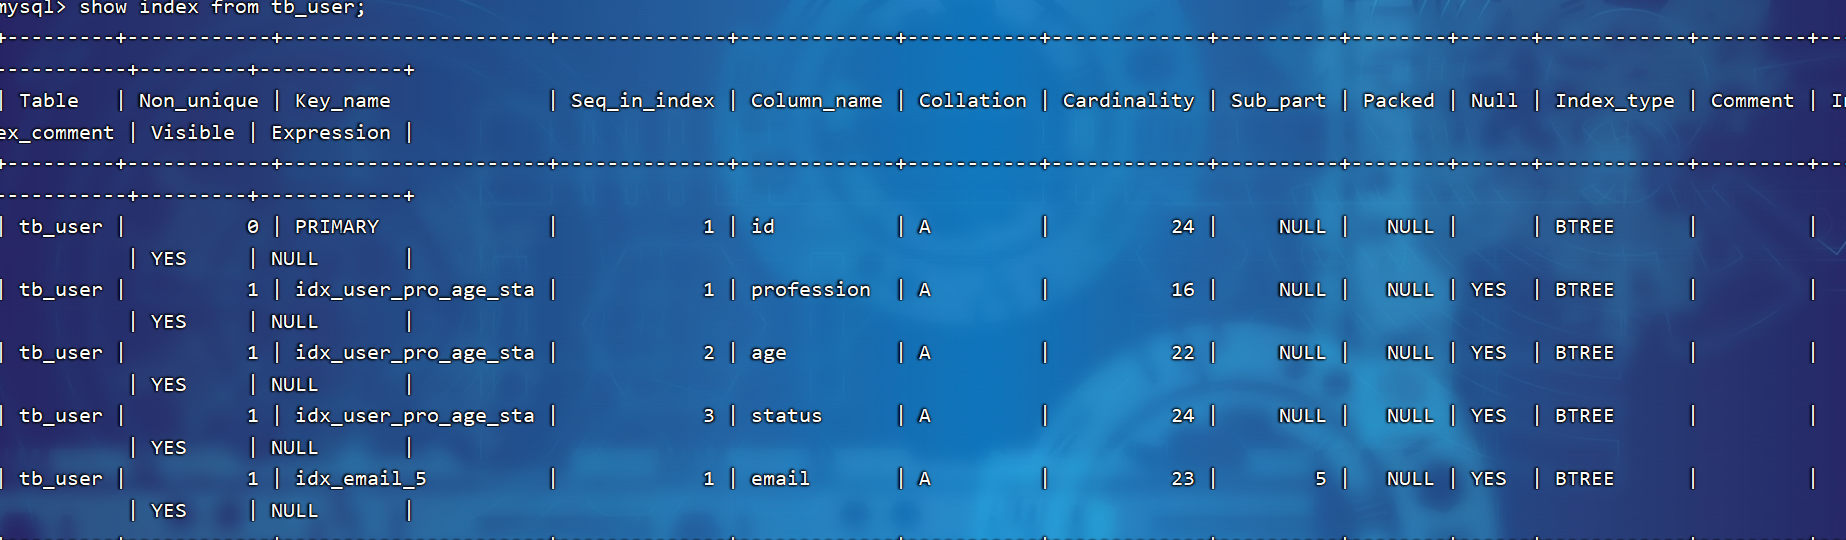
清理数据,将tb_user表中的索引保留如下即可:
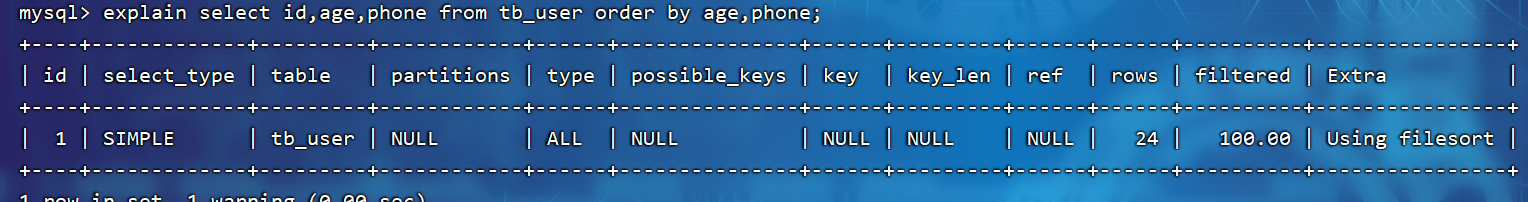
无索引时(Extra列为using filesort):
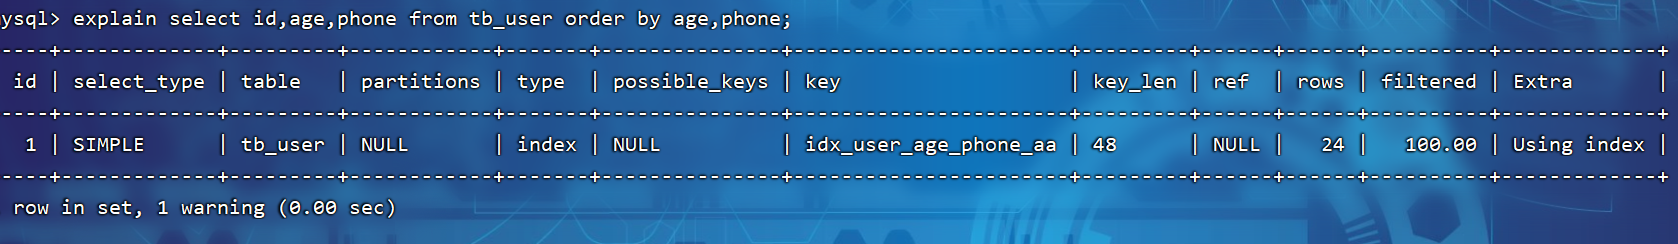
创建索引:
create index idx_user_age_phone_aa on tb_user(age,phone);
再次执行explain(Extra列为using index):
降序explain时:
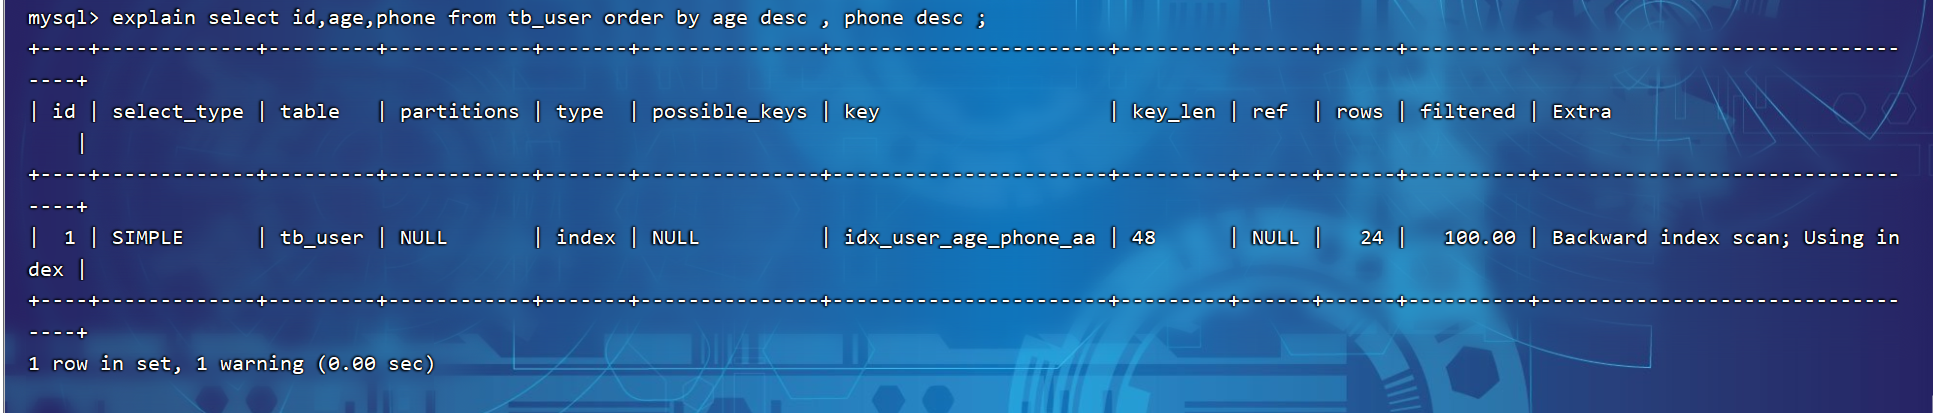
出现了Backward index scan,说明索引进行反向索引(默认创建索引,不加声明时是升序创建的)
先排phone,再排age时:
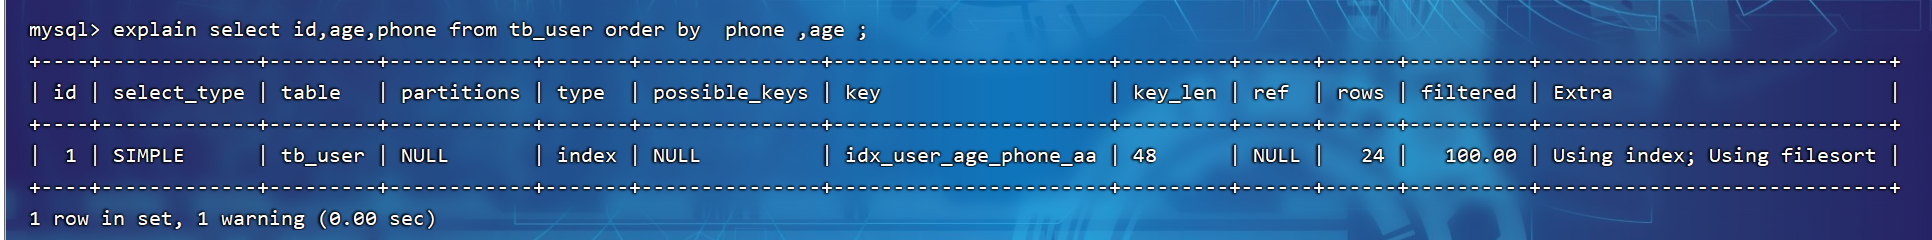
排序时,也需要满足最左前缀法则,否则也会出现 filesort。因为在创建索引的时候, age是第一个字段,phone是第二个字段,所以排序时,也就该按照这个顺序来,否则就会出现 Using filesort。
age升序,phone降序时:
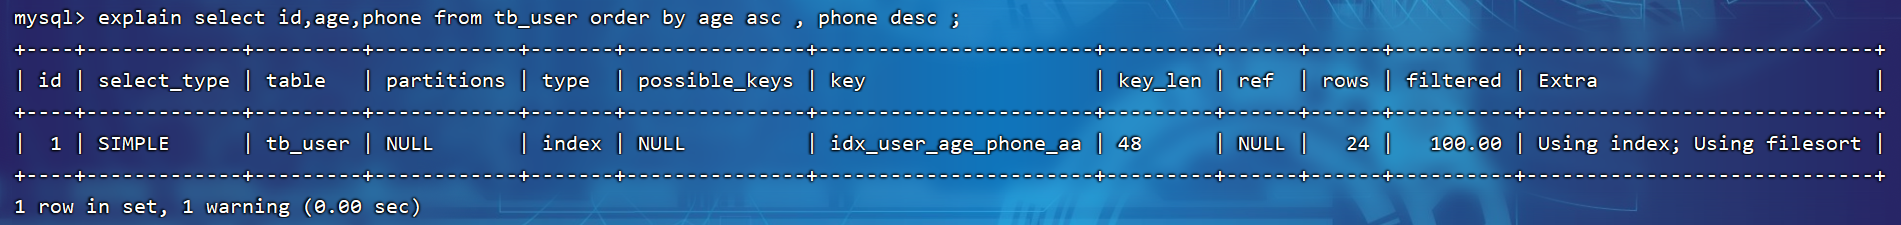
可通过创建联合索引(age 升序排序,phone 倒序排序)优化:
create index idx_user_age_phone_ad on tb_user(age asc,phone desc) ;
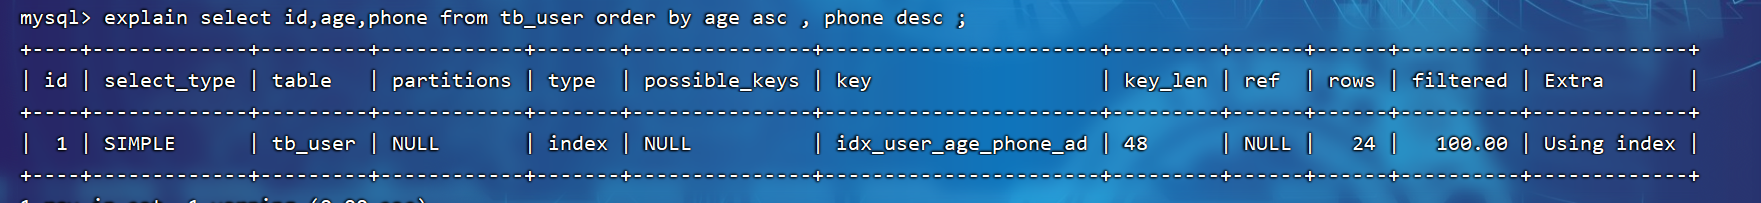
Order by优化注意事项:
1)要满足最左前缀原则
2)尽量使用覆盖索引
3)注意升序降序,可根据具体细节调整创建索引
4)如果不可避免的出现filesort,大数据量排序时,可以适当增大排序缓冲区大小
sort_buffer_size(默认256k)。
编辑器修改(SET [GLOBAL] sort_buffer_size = 4 * 1024 * 1024;)
配置类永久修改
# 4.Group By优化
删除tb_user表的所有索引
drop index idx_user_pro_age_sta on tb_user;
drop index idx_email_5 on tb_user;
drop index idx_user_age_phone_aa on tb_user;
drop index idx_user_age_phone_ad on tb_user;
2
3
4
没有索引的情况
explain select profession , count(*) from tb_user group by profession ;
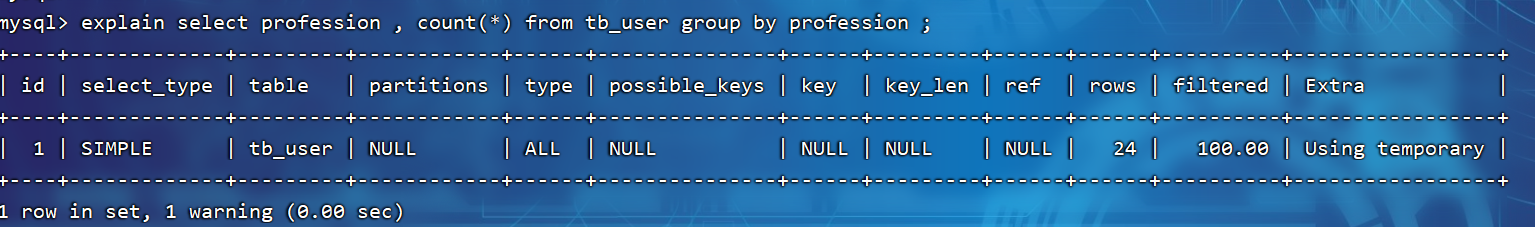
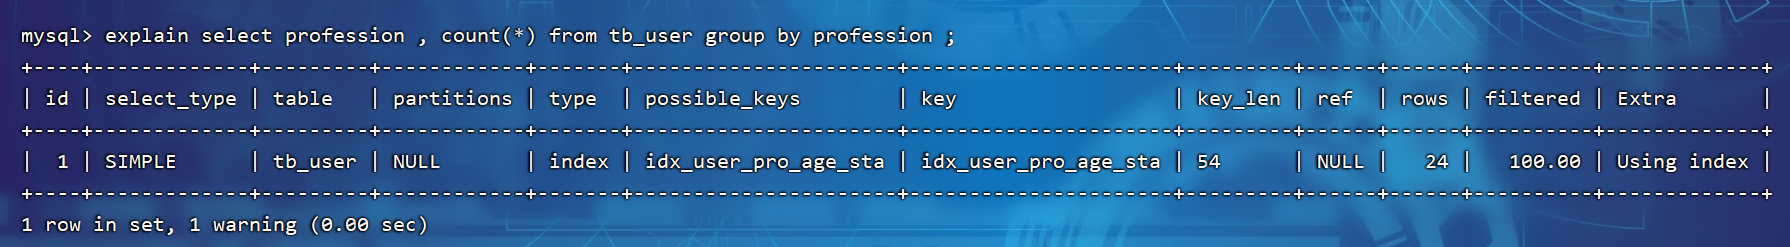
创建联合索引:
create index idx_user_pro_age_sta on tb_user(profession , age , status);
再次查看执行计划:
只用age排序再试一下:
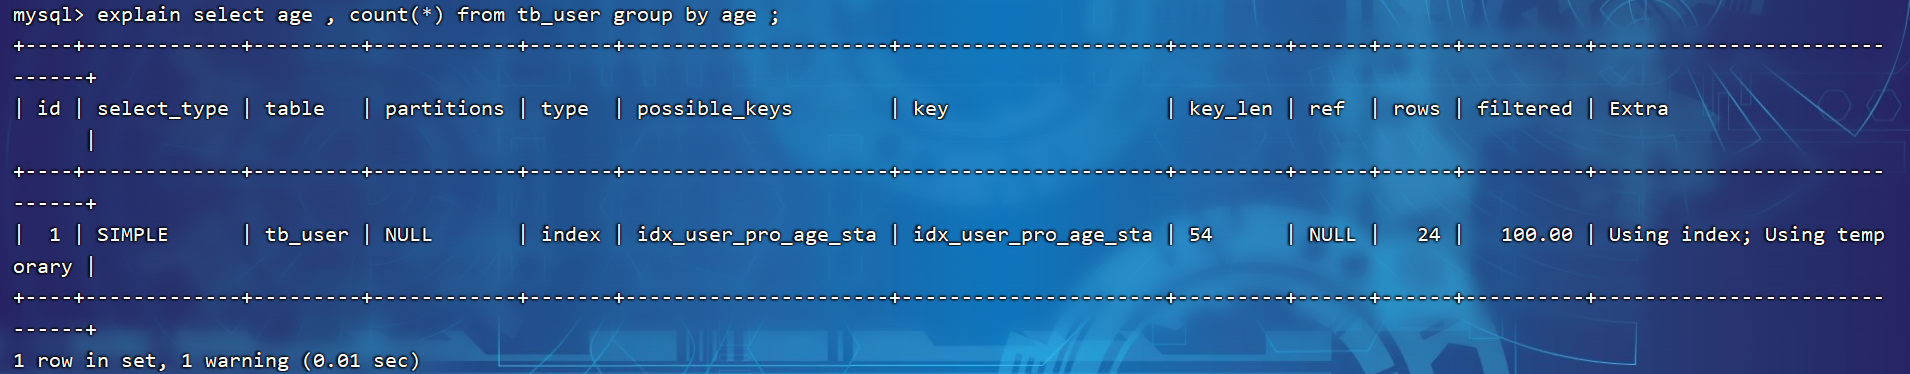
extra中出现了using temporary,由此可见,group by也是满足最左前缀原则的
所以,在分组操作中,我们需要通过以下两点进行优化,以提升性能:
在分组操作时,可以通过索引来提高效率。
分组操作时,索引的使用也是满足最左前缀法则的。
# 5.Limit 优化
在数据量比较大时,如果进行limit分页查询,在查询时,越往后,分页查询效率越低。
因为,当在进行分页查询时,如果执行 limit 2000000,10 ,此时需要MySQL排序前2000010 记录,仅仅返回 2000000 - 2000010 的记录,其他记录丢弃,查询排序的代价非常大 。
优化思路: 一般分页查询时,通过创建 覆盖索引 能够比较好地提高性能,可以通过覆盖索引加子查询形式进行优化。
select * from tb_sku t , (select id from tb_sku order by id
limit 2000000,10) a where t.id = a.id;
2
注意:不能用in,因为in的后面不支持limit,所以只能将查询结果放入表a中
# 6.Count优化
1.概述
如果数据量很大,在执行count操作时,是非常耗时的。
MyISAM 引擎把一个表的总行数存在了磁盘上,因此执行 count(*) 的时候会直接返回这个
数,效率很高; 但是如果是带条件的count,MyISAM也慢。(存磁盘)
InnoDB 引擎就麻烦了,它执行 count(*) 的时候,需要把数据一行一行地从引擎里面读出
来,然后累积计数。(统计)
如果说要大幅度提升InnoDB表的count效率,主要的优化思路:自己计数(可以借助于redis这样的数据库进行,但是如果是带条件的count又比较麻烦了)。
2.用法
count() 是一个聚合函数,对于返回的结果集,一行行地判断,如果 count 函数的参数不是
NULL,累计值就加 1,否则不加,最后返回累计值。
| count 用法 | 含义 |
|---|---|
| count (主键) | InnoDB 引擎会遍历整张表,把每一行的主键 id 值都取出来,返回给服务层。服务层拿到主键后,直接按行进行累加(主键不可能为 null)。 |
| count (字段) | 没有 not null 约束:InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,服务层判断是否为 null,不为 null,计数累加。 有 not null 约束:InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,直接按行进行累加。 |
| count (数字) | InnoDB 引擎遍历整张表,但不取值。服务层对于返回的每一行,放一个数字 “1” 进去,直接按行进行累加。 |
| count(*) | InnoDB 引擎并不会把全部字段取出来,而是专门做了优化,不取值,服务层直接按行进行累加。 |
按照效率排序的话,count(字段) < count(主键 id) < count(1) ≈ count(),所以尽量使用 count()。
# 7.update优化
update course set name = 'javaEE' where id = 1 ;
当我们在执行SQL语句时,会锁定id为1这一行的数据,然后事务提交之后,行锁释放。
update course set name = 'SpringBoot' where name = 'PHP' ;
当我们开启多个事务,在执行上述的SQL时,我们发现行锁升级为了表锁。 导致该update语句的性能大大降低。
注意:InnoDB的行锁是针对索引加的锁,不是针对记录加的锁 ,并且该索引不能失效,否则会从行锁升级为表锁 。